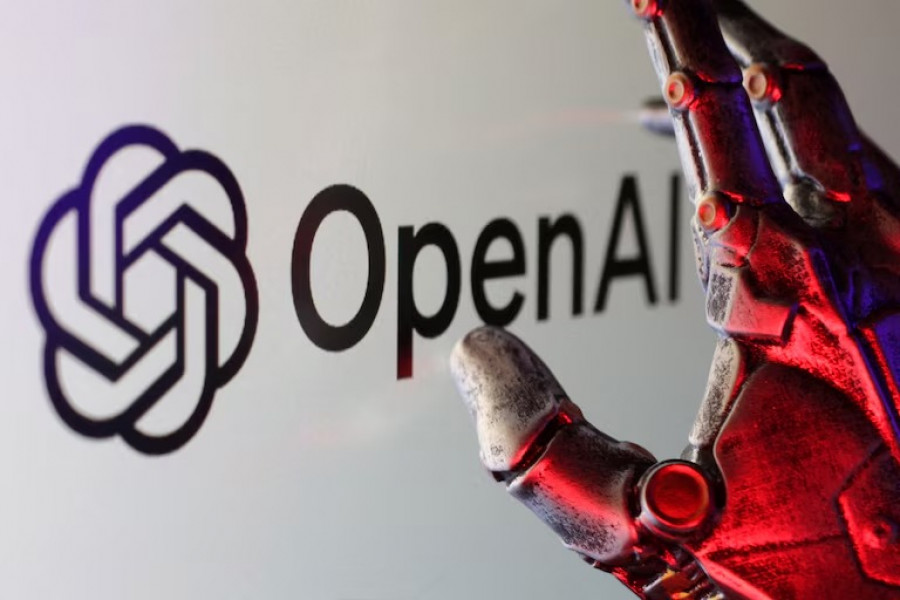
Fokus OpenAI saat ini pada musik menyusul beberapa tahun terakhir yang berfokus pada pemrosesan bahasa dan model sintesis ucapan.
Dalam fase baru ini, pihak perusahaan telah menghidupkan kembali inisiatif-inisiatif pembangkitan musik sebelumnya, tetapi melakukannya dengan mengintegrasikan kemajuan terbaru dalam kecerdasan buatan untuk analisis dan penciptaan kembali suara.
Menurut sumber yang dikutip oleh The Information, alat tersebut tidak hanya menerima perintah teks, seperti deskripsi terperinci tentang karakter atau gaya musik yang diinginkan, tetapi juga memungkinkan penggunaan sampel audio sebagai referensi.
Hal ini akan memungkinkan untuk meminta iringan untuk rekaman vokal, dasar ritmis atau melodi yang melengkapi karya yang sudah ada atau sedang dikembangkan sebelumnya dengan menargetkan keluaran AI ke afinitas dan suara musikal tertentu.
Proposal ini ditujukan pada masyarakat umum dan pembuat konten serta profesional di industri audiovisual, yang dapat menggunakan alat ini untuk menambahkan musik ke video, menghasilkan iringan yang dipersonalisasi dan mengadaptasi musik secara real time ke adegan yang dihasilkan oleh kecerdasan buatan.
Satu dari beberapa aspek paling inovatif dari proyek ini adalah aliansi strategis antara OpenAI dan mahasiswa dari Juilliard School di New York, Amerika Serikat, sebuah sekolah seni dan musik ternama. Para mahasiswa berkolaborasi dalam pembuatan anotasi skor yang akan berfungsi sebagai materi pelatihan bagi sistem tersebut.
Pendekatan ini berupaya agar AI tidak hanya menginternalisasi struktur formal musik, tetapi juga variabel ekspresif dan kompleksitas seperti dinamika, intensi, dan perkembangan harmoni.
Bekerja dengan para ahli musik menunjukkan perbedaan dari platform pembangkitan suara otomatis lainnya, yang mengutamakan musikalitas dan rasa artistik di luar rangkaian nada atau pola berulang yang sederhana.
Saat ini, OpenAI belum mengonfirmasi tanggal rilis pasti untuk alat generatif musik tersebut, juga belum menjelaskan apakah alat itu akan muncul sebagai solusi mandiri atau diintegrasikan ke dalam produk yang sudah ada, seperti ChatGPT atau aplikasi video baru Sora.
Satu dari beberapa opsi ini akan memperluas basis penggunanya secara signifikan: dari mereka yang ingin memberi skor pada adegan secara otomatis dengan AI hingga mereka yang mengeksplorasi bentuk baru kreativitas digital secara real time.
Para analis berpendapat integrasi dengan ChatGPT akan memfasilitasi penggunaannya oleh masyarakat umum, sementara menambahkan kemampuan musik ke lingkungan visual seperti Sora akan mewakili perubahan paradigma untuk pembuatan audiovisual otomatis, menyederhanakan produksi di berbagai bidang seperti penyuntingan video, periklanan, dan permainan video.
ChatGPT memungkinkan pengguna berinteraksi dengan audio di platform dan aplikasi tertentu yang didukung. Pengguna dapat merekam suara atau mengunggah berkas audio dan sistem memproses pesan-pesan ini menggunakan pengenalan suara otomatis. Fitur ini mengubah konten lisan menjadi teks untuk memudahkan pemahaman dan respons oleh kecerdasan buatan.
Setelah transkripsi, ChatGPT menganalisis informasi dan merespons dengan teks tertulis atau, dalam beberapa kasus, pesan suara digital. Kemampuan ini memperluas kemungkinan komunikasi dan membuat interaksi lebih mudah diakses, terutama bagi mereka yang lebih menyukai pesan audio daripada teks.
Editor: Aspian Nur